PorJMJaime Montero
Cómo desarrollar una aplicación con IA: de la idea a producción
Desarrollar una aplicación con IA significa diseñar un producto de software que usa modelos dentro de un flujo controlado. La interfaz, los datos, las reglas, las integraciones, la identidad, la seguridad, las evaluaciones y la operación importan tanto como el modelo. Una demo que responde bien a tres ejemplos puede ser útil para aprender, pero todavía no es un sistema listo para clientes o empleados.
Esta guía cubre el proceso técnico y de producto desde la idea hasta producción. Si buscas contratar la construcción, consulta el servicio de desarrollo de aplicaciones a medida. Si todavía no sabes si necesitas una interfaz conversacional, un workflow o un agente, empieza por la comparación entre agente de IA y chatbot.
Empieza por la decisión que mejora, no por “añadir IA”
Una idea como “crear una app con ChatGPT” no define un producto. Describe la decisión o tarea que debe mejorar, quién la realiza, qué información necesita y qué ocurre después. “Preparar un borrador de informe a partir de fuentes aprobadas para que una analista lo revise” es comprobable. “Tener un asistente inteligente para todo” no lo es.
Formula una hipótesis con una condición de fracaso. La aplicación debería reducir el tiempo de preparar el informe manteniendo cobertura de fuentes y sin introducir errores críticos. Si el equipo dedica más tiempo a corregir que antes, el caso no pasa aunque la interfaz impresione. Si no existe una baseline, mide primero una muestra del trabajo actual.
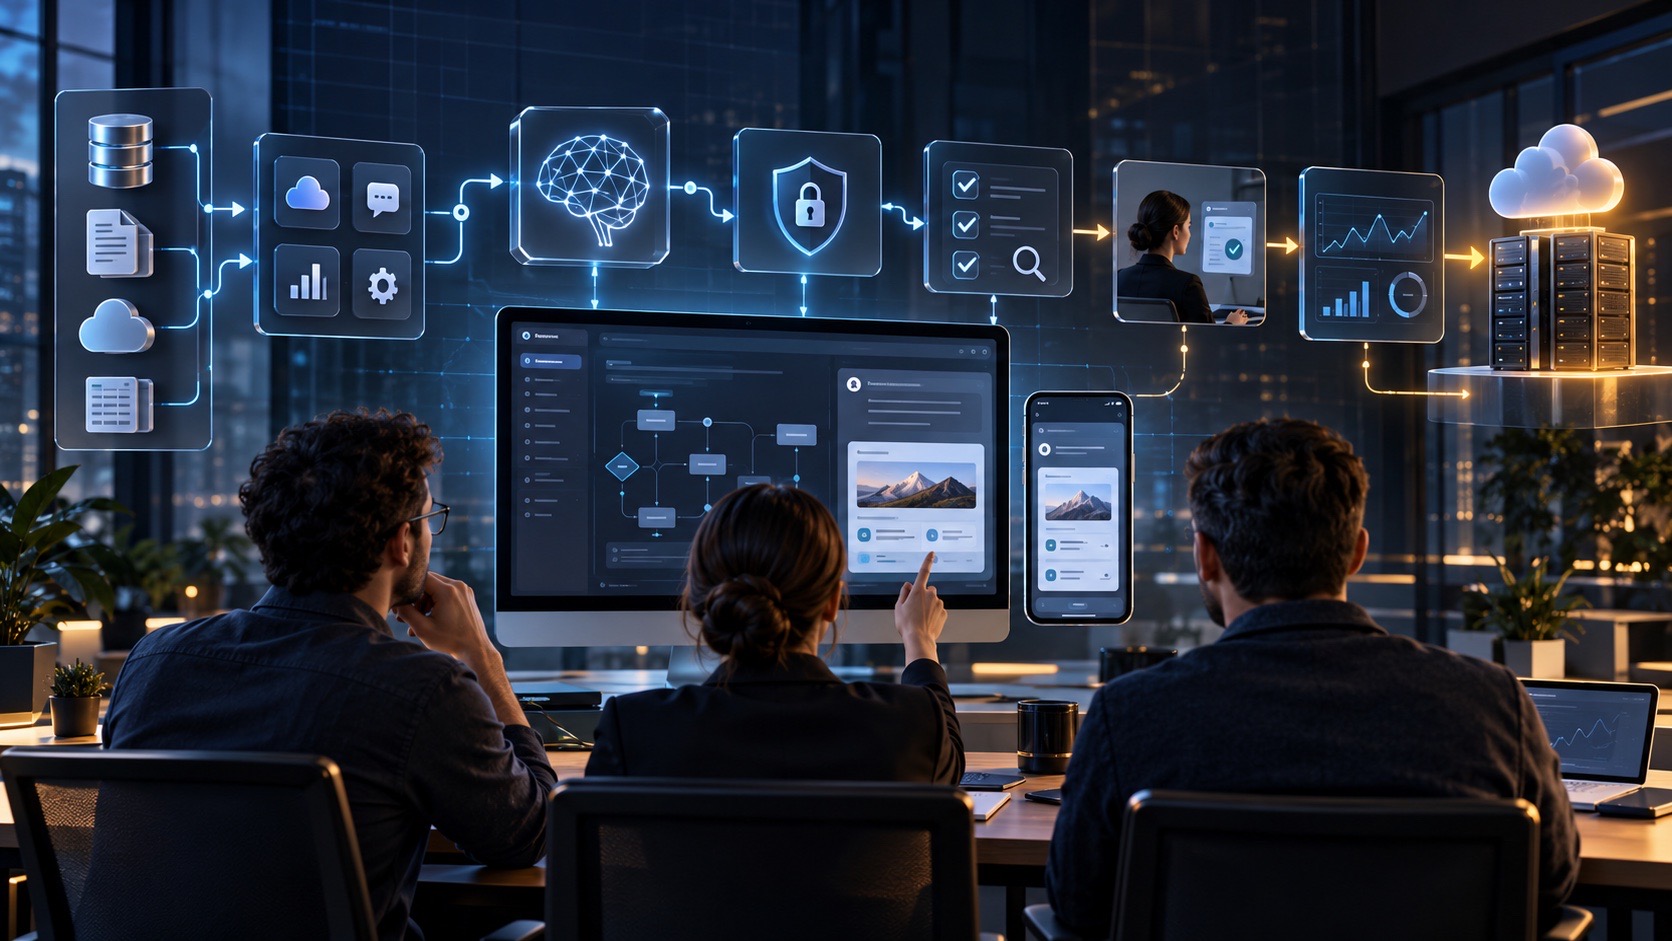
Problema
Usuario y decisión
Datos
Fuentes y permisos
Prototipo
Camino crítico
Evals
Calidad y riesgo
Producción
Seguridad y operación
Mejora
Logs, coste y cambios
1. Escribe el contrato del producto antes de elegir arquitectura
El contrato define entradas, salidas, límites y responsabilidad. Empieza por un “job to be done” observable: quién usa la app, en qué momento, qué trae, qué espera recibir y qué hará con el resultado. Añade requisitos no funcionales desde el principio: latencia tolerable, disponibilidad, privacidad, accesibilidad, idiomas, volumen y coste máximo por operación.
- Usuario: rol, conocimientos, permisos y contexto de uso.
- Entrada: datos obligatorios, opcionales y prohibidos.
- Resultado: formato, criterio de calidad y siguiente acción.
- Fallo seguro: cuándo pedir información, derivar o no responder.
- Propietario: quién acepta cambios, incidencias y deuda.
Separa el camino crítico de las funciones atractivas. Si la aplicación necesita recibir una solicitud, consultar dos fuentes y proponer una clasificación, valida eso antes de añadir paneles, personalización o múltiples agentes. Cuantas más capas incorpores antes de demostrar el núcleo, más difícil será saber por qué mejora o falla.
2. Diseña datos y permisos como parte del producto
El modelo no corrige una base de datos sin propiedad, duplicados ni vigencia. Define para cada fuente quién la mantiene, qué campos entran, con qué finalidad, cuánto tiempo se conservan y qué ocurre cuando cambian. Usa una muestra pequeña y controlada para el prototipo; no copies producción completa “para tener realismo”.
Aplica identidad y autorización fuera del prompt. El modelo no debe decidir si una persona puede ver un cliente, modificar una factura o ejecutar una acción. Esa decisión pertenece a una capa determinista con sesión, rol, política y auditoría. Recupera solo los datos permitidos para la solicitud concreta y devuelve referencias que una persona pueda comprobar.
| Capa | Responsabilidad | Control |
|---|---|---|
| Origen | Sistema o documento autorizado | Propietario, fecha y alcance |
| Preparación | Normalizar, dividir y enriquecer | Versiones y trazabilidad |
| Acceso | Entregar solo contexto permitido | Identidad y autorización deterministas |
| Uso | Generar, clasificar o decidir una herramienta | Esquema, límites y evidencia |
| Retención | Logs, feedback y borrado | Minimización y política explícita |
3. Elige el patrón más simple que resuelva el caso
No toda aplicación necesita recuperación semántica, herramientas o agentes. Una clasificación de campos conocidos puede resolverse con reglas y una llamada estructurada. Una búsqueda sobre documentación interna puede necesitar recuperación con referencias. Un proceso con varios pasos y sistemas puede requerir un workflow explícito. Reserva un agente para problemas donde la selección dinámica de herramientas aporte valor y pueda evaluarse.
| Patrón | Úsalo cuando | Riesgo a vigilar |
|---|---|---|
| Reglas + modelo | La decisión tiene límites claros | Convertir la salida en autoridad |
| RAG con fuentes | La respuesta depende de conocimiento cambiante | Recuperación irrelevante o sin permisos |
| Workflow | Los pasos y controles son conocidos | Estados incompletos y reintentos |
| Agente con herramientas | Debe elegir acciones en contexto variable | Herramienta, argumentos y autonomía |
| Modelo propio o ajustado | Datos y evals prueban una ventaja | Coste, mantenimiento y regresión |
Separa las partes variables de las deterministas. Usa código para cálculos, permisos, límites, identificadores y transacciones. Usa el modelo para interpretar lenguaje, resumir, clasificar o proponer dentro de un esquema. Si una salida debe ser JSON, valida el esquema y rechaza lo que no cumpla; la estructura correcta no demuestra que el contenido sea verdadero.
4. Prototipa el recorrido completo, no una pantalla aislada
El prototipo debe recorrer una entrada realista hasta una salida que una persona pueda aceptar o rechazar. Incluye autenticación básica, una muestra de datos, el modelo, el control humano y el registro del resultado. Una maqueta de chat que no conecta con el proceso solo valida conversación, no valor operativo.
Usa un entorno separado, datos sintéticos o anonimizados cuando sea posible y permisos de solo lectura. Limita herramientas, volumen y coste. Muestra al usuario qué fuente se usó, qué parte generó el modelo y qué acción ocurrirá. La interfaz debe facilitar corrección y derivación, no empujar a aceptar por defecto.
Define desde el primer día un pequeño dataset de casos. Incluye ejemplos normales, bordes, entradas incompletas y casos que deben bloquearse. Cada incidencia nueva útil puede convertirse en una prueba de regresión. Así el aprendizaje deja de vivir solo en conversaciones y se convierte en evidencia repetible.
5. Construye evals antes de optimizar prompts
Las aplicaciones generativas son variables, por lo que una prueba manual no basta. La guía oficial de buenas prácticas de evaluación de OpenAI recomienda evaluar pronto y con frecuencia, diseñar pruebas específicas de la tarea, usar distribuciones representativas y calibrar la automatización con juicio humano. También advierte contra métricas genéricas y la evaluación basada en “parece que funciona”.
Define criterios por dimensión: exactitud factual, cobertura, formato, tono cuando sea relevante, uso de fuentes, selección de herramienta, argumentos, cumplimiento de política y decisión de derivar. Algunos pueden verificarse con código; otros requieren revisión humana o un grader calibrado. Conserva ejemplos que distingan entre un error menor y uno crítico.
Para agentes, no evalúes solo la respuesta final. La documentación de evaluación de workflows de agentes propone revisar trazas, herramientas, guardrails y handoffs. Una respuesta aparentemente correcta puede haber consultado una fuente no autorizada o realizado una escritura innecesaria.
| Dimensión | Prueba | Umbral de decisión |
|---|---|---|
| Utilidad | ¿Resuelve la tarea y cubre lo necesario? | Acordado por tipo de caso |
| Factualidad | ¿La salida coincide con fuente o regla? | Cero errores críticos |
| Acción | ¿Elige herramienta y argumentos correctos? | Sin escrituras fuera de alcance |
| Seguridad | ¿Resiste inyección, abuso y datos prohibidos? | Bloqueo o derivación segura |
| Operación | Latencia, coste, errores y recuperación | SLO y presupuesto definidos |
6. Integra seguridad en el ciclo de desarrollo
Una app con IA sigue siendo software y hereda sus riesgos: dependencias, secretos, autenticación, autorización, inyección, exposición de datos, configuración y cadena de suministro. El Secure Software Development Framework de NIST propone preparar a personas, procesos y tecnología, proteger los componentes, producir software seguro y responder a vulnerabilidades residuales. Integra esas prácticas en el ciclo, no como auditoría final.
Añade riesgos propios de modelos: prompt injection directa o indirecta, extracción de información, salida insegura, dependencia excesiva, uso indebido de herramientas y consumo no controlado. El proyecto OWASP GenAI Security mantiene una referencia específica para aplicaciones con modelos de lenguaje. Úsala para modelar amenazas, no como checklist que garantiza seguridad.
La guía de seguridad para construir agentes de OpenAI recomienda aislar texto no confiable, limitar cómo fluye hacia acciones, usar salidas estructuradas, approvals, guardrails y evals. En la práctica: credenciales con mínimo privilegio, herramientas estrechas, allowlists, confirmación para acciones sensibles y separación entre lectura y escritura.
7. Diseña operación, observabilidad y coste antes del lanzamiento
Producción necesita saber qué ocurrió sin registrar información innecesaria. Conserva identificadores, versión de prompt y modelo, herramientas invocadas, latencia, consumo, resultado de validaciones, decisión humana e incidencia. Redacta o minimiza datos sensibles y define retención. Los logs deben permitir reproducir un problema sin convertirse en una copia paralela de los datos de negocio.
Configura límites por usuario, organización, tarea y periodo. Estima coste por operación con entradas y salidas representativas, pero añade infraestructura, recuperación, almacenamiento, observabilidad, soporte y evaluación. Una respuesta barata puede ser cara si obliga a correcciones frecuentes. Revisa el marco de ROI y TCO de una automatización con IA antes de extrapolar el piloto.
- Alertas: errores, latencia, coste, degradación y abuso.
- Fallback: reintento acotado, modelo alternativo o proceso manual.
- Rollback: volver a una versión conocida de código, prompt o modelo.
- Soporte: responsable, severidad, tiempo de respuesta y comunicación.
- Cambio: evals obligatorias según componente y riesgo.
Fases recomendadas: descubrimiento, piloto, producto y escala
Descubrimiento
Mapea el proceso, entrevista usuarios, identifica fuentes, mide baseline y define criterios. El entregable no es una app: es una hipótesis priorizada, un contrato de datos y una decisión informada sobre si merece prototipo.
Piloto controlado
Construye el recorrido mínimo con datos limitados, evals iniciales y supervisión. Trabaja en modo sombra o asistencia. El objetivo es descubrir fallos y estimar utilidad, no acelerar adopción. La guía de pilotos de automatización con IA detalla pruebas y umbrales.
Producto inicial
Añade identidad, autorización, integraciones resilientes, interfaz accesible, observabilidad, límites y soporte. Migra el dataset a una suite de regresión y prueba cargas y fallos. Documenta operación y forma a usuarios y responsables.
Escala
Amplía cohortes solo cuando calidad, coste y riesgo se mantienen. No confundas más usuarios con más valor. Revisa segmentos, excepciones y capacidad de soporte. Cada nuevo proceso, fuente o herramienta modifica el perfil de riesgo y necesita pruebas propias.
Decide qué construir, comprar o integrar
Una aplicación a medida no exige desarrollar cada componente. Divide el sistema en capacidades: identidad, base de datos, almacenamiento, interfaz, notificaciones, búsqueda, modelo, observabilidad y lógica propia. Compra o usa un servicio gestionado cuando la capacidad es estándar y su dependencia resulta aceptable. Construye donde exista una regla diferencial, un flujo propio, una experiencia crítica o una necesidad de control que el producto genérico no cubre.
Evalúa proveedores con el mismo contrato del producto: residencia y uso de datos, retención, subprocesadores, controles de acceso, límites, disponibilidad, exportación, portabilidad, versiones y procedimiento de salida. No conviertas una API cómoda en una dependencia invisible. Mantén una capa de adaptación alrededor de servicios que puedan cambiar y conserva pruebas que detecten regresiones cuando actualices modelo o configuración.
La decisión también puede cambiar por fase. Un prototipo puede usar componentes gestionados para aprender rápido; producción puede exigir más aislamiento, controles o capacidad. Evita reescribir por principio y evita quedar atrapado por accidente. Documenta qué parte del valor pertenece al flujo y los datos de la empresa y qué parte depende de un proveedor concreto.
Diseña la experiencia para incertidumbre y revisión
Una buena interfaz de IA no finge certeza. Muestra fuentes, estado, alcance y acciones disponibles. Permite corregir una entidad, editar el borrador, elegir otra fuente o derivar. Cuando la respuesta está incompleta, la interfaz debe ayudar a completar el caso en lugar de ocultarlo tras un texto convincente. Para tareas sensibles, separa claramente recomendación, decisión y ejecución.
Evita usar un único chat para todos los flujos. Formularios guiados reducen ambigüedad; tablas facilitan revisar lotes; comparadores permiten validar cambios; colas ayudan a priorizar excepciones. La conversación es útil cuando el usuario necesita explorar, pero también puede esconder estado, permisos y consecuencias. Elige la interacción que hace más fácil detectar errores y completar el trabajo correcto.
Recoge feedback estructurado además de comentarios libres: correcto, incompleto, fuente equivocada, acción incorrecta, fuera de alcance o riesgo. Esas categorías alimentan el dataset y permiten saber si una versión mejora. Un pulgar arriba aislado rara vez explica qué funcionó; una corrección vinculada al caso puede convertirse en una prueba reutilizable.
Errores que convierten una demo en deuda
- Chat por defecto: elegir conversación aunque el trabajo necesite formularios, revisión o acciones estructuradas.
- Agente prematuro: añadir autonomía donde un workflow sería más evaluable.
- Prompt como seguridad: confiar en instrucciones para permisos o transacciones.
- Sin dataset: corregir ejemplos aislados y reintroducir fallos anteriores.
- Datos sin dueño: recuperar documentos desactualizados o fuera de permiso.
- Coste solo de tokens: omitir infraestructura, revisión, soporte y mejora.
- Observabilidad invasiva: guardar prompts y respuestas completos sin necesidad ni retención.
- Lanzamiento sin salida: no disponer de fallback, rollback o responsable de parada.
Checklist antes de pasar a producción
- Problema, usuario, resultado y condición de fracaso definidos.
- Baseline y criterios de utilidad comparables.
- Fuentes, permisos, retención y propietarios documentados.
- Patrón de arquitectura justificado por el caso.
- Autenticación y autorización fuera del modelo.
- Dataset representativo con casos adversos y prohibidos.
- Evals de respuesta, herramientas, seguridad, coste y latencia.
- Revisión humana calibrada para decisiones sensibles.
- Secretos, dependencias, entradas y salidas protegidos.
- Logs mínimos, alertas, rate limits y presupuesto operativo.
- Fallback, rollback, soporte y respuesta a incidentes probados.
- Propietario de producto y calendario de revisión asignados.
Cómo puede ayudar Auttomai
Auttomai diseña aplicaciones a medida conectando producto, experiencia de usuario, datos, modelos, automatización y sistemas de negocio. El trabajo puede comenzar con descubrimiento y un prototipo controlado, evitando comprometer una arquitectura compleja antes de validar la decisión central. Cuando el caso pasa sus gates, se industrializa con evaluación, seguridad y operación.
Puedes ver un ejemplo en el caso de desarrollo de una aplicación con IA, revisar el servicio de aplicaciones a medida para empresas o contactar con Auttomai. La conversación debe empezar por el flujo, los usuarios y la evidencia necesaria, no por una promesa de sustituir todo con un agente.
Preguntas frecuentes
¿Qué diferencia una aplicación con IA de un chatbot?
Una aplicación con IA resuelve un flujo de negocio completo: identidad, datos, permisos, interfaz, integraciones, reglas, evaluación y operación. Puede incluir conversación, pero no depende de ella. Un chatbot es solo una posible interfaz o componente.
¿Hay que entrenar un modelo propio?
Normalmente no al principio. Muchas aplicaciones pueden validar su utilidad con modelos existentes, recuperación de información, herramientas y reglas. Entrenar o ajustar un modelo tiene sentido cuando los datos, el volumen, la tarea y las evaluaciones demuestran una ventaja suficiente.
¿Cuánto cuesta desarrollar una app con IA?
Depende del alcance, integraciones, seguridad, diseño, volumen, modelos, datos y nivel de operación. Separa construcción inicial de costes recurrentes de inferencia, infraestructura, observabilidad, soporte, evaluación y mejora. Una tarifa universal sin esos supuestos no es comparable.
¿Cómo se prueba una aplicación generativa?
Combina pruebas deterministas del software con un dataset representativo, criterios de calidad por tarea, casos adversos, revisión humana calibrada y evals repetibles. Debes medir también selección de herramientas, argumentos, políticas, latencia, coste e incidencias.
¿Qué datos necesita el primer prototipo?
Solo los necesarios para probar la decisión central. Empieza con una muestra controlada, documentada y permitida. No copies toda la base de producción para acelerar una demo; diseña minimización, acceso, retención y borrado desde el principio.
¿Cuándo está lista para producción?
Cuando cumple los criterios de utilidad y riesgo, tiene autenticación y permisos, evals repetibles, observabilidad, límites de coste, respuesta a incidencias, rollback, propietario operativo y soporte. Que una demo funcione varias veces no basta.
Jaime Montero
Fundador de Auttomai. Trabaja en la aplicación de IA, automatización y sistemas de marketing a procesos empresariales, con foco en control humano, medición y utilidad operativa.
Perfil de Jaime Montero en LinkedIn